여러분,
패티가 가설 검정에서 작은 P값을 파악하도록 마크를 돕는 과정을 계속 지켜보도록 합시다. 이 이야기의 첫 번째 부분은 여기에서 확인할 수 있습니다.
패티와 마크는 잠시 대화를 나누며 마크가 분석 중이던 데이터 중 일부를 살펴보았다.
“마크, 간단히 설명하자면, 두 가지 전달 효율(TE)을 비교한다고 가정해 봅시다. 예를 들어, TE 측정값을 100개 수집했고, 이 값들이 통계적으로 특정 값보다 큰지 확인하고 싶다고 합시다. 그러면 귀무가설은 94%이고, 대립가설은 94%보다 크다는 것이 되겠네요,”라고 패티가 말했다.
패티는 화이트보드 앞으로 가서 다음과 같이 적었다:
Ho: 평균 = 94%
H1: 평균 >94%
“100개의 측정값의 평균을 100%, 표준편차를 10%라고 가정해 봅시다,”라고 그녀가 말을 이었다.
“그게 바로 데이터가 보여준 내용과 거의 정확히 일치하네요,”라고 마크가 대답했다.
패티는 이 데이터를 Minitab에 입력한 후 다음과 같은 출력 결과를 얻었습니다.
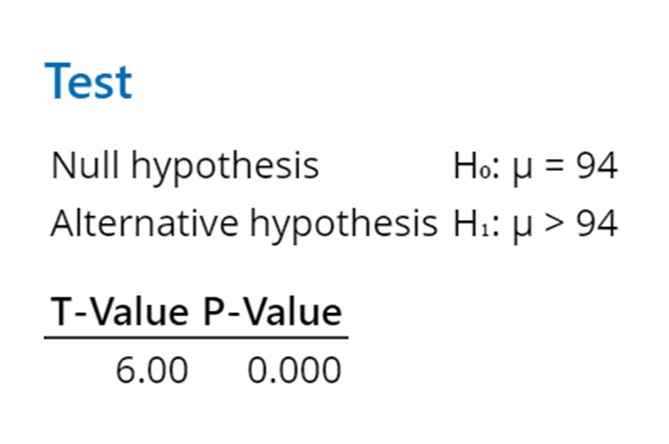
“따라서 우리는 귀무가설을 기각하고, 평균(즉, 100)이 94%보다 통계적으로 더 크다고 결론지을 수 있습니다.”라고 패티가 말했다.
“근데 P값이 0.000이라고 나오잖아,” 마크가 투덜거렸다. “그래서 마이크가 나한테 잔소리를 한 거야,” 그는 한숨을 쉬며 말했다.
“Minitab을 사용하여 평균 0, 표준편차 1인 정규 분포의 그래프를 그려보고, 그래프상에서 6이 어디에 위치하는지 확인해 봅시다. 이 6은 T-값 6과 동일합니다(표본 크기가 400 이상으로 큰 경우에는 Z-값과 동일합니다).”라고 패티가 말했습니다. 그림 1을 참조하십시오.

그림 1. Minitab의 그래픽 출력.
“와, P-값이 9.8659×10⁻¹⁰이네,” 마크가 감탄하며 말했다.
“결국 이 그래프 작성 기능조차도 T값이나 Z값이 약 8보다 클 경우 P-값을 0으로 계산하는 것으로 나타났습니다,”라고 패티가 확인했다.
“아이고, T 값이 8 이상이면 마이크가 여전히 나를 혼낼지도 모르겠네,” 마크가 투덜거렸다.
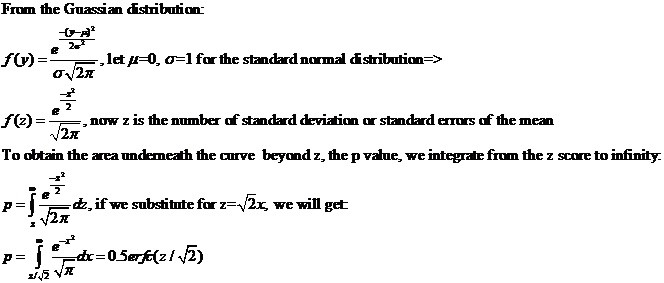
“용기를 내세요,” 패티가 말했다. “가우시안 적분의 미적분 문제를 풀었더니, 그것이 보완 오차 함수라는 것을 알아냈어요.엑셀®은 최대 37.5까지의 t 또는 z 값에 대한 보완 오차 함수를 정확하게 계산해 줍니다. 이 경우, 관련 P 값은 4.61E-308입니다.” 그림 2를 참조하십시오.
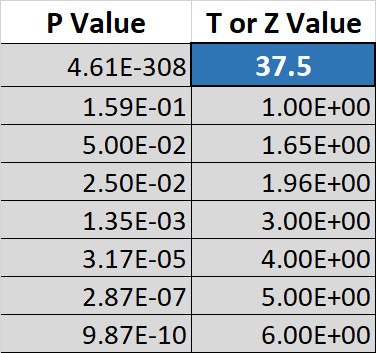
그림 2. P값을 계산하기 위한 패티의 엑셀 스프레드시트.
마크가 애원하듯 물었다. “만약 37.5보다 크다면요?”
“우주에 원자가 고작1080개 정도밖에 없다는 점을 생각하면, 4.61E-308 같은 건 걱정할 필요 없어요. 이건 2.16E307분의 1 확률이니까요,”라고 패티가 농담을 던졌다. “하지만 만약 정말로 T = 37.5를 넘어설 필요가 있다면, 제가 T가 1000을 훨씬 넘는, 아마도 어떤 수치든 처리할 수 있는 기법을 개발해 두었습니다. 다만엑셀®으로는 할 수 없어요,”라고 그녀가 말을 이었다.
마크는 기대에 찬 목소리로 물었다. “그럼엑셀® 스프레드시트를 받을 수 있는 거고, 혹시 T = 37.5를 넘어가야 할 상황이 생기면 도와주실 거죠?”
“물론이지,” 패티가 말했다. “아, 그리고 마이크 매디건한테 너무 겁먹지 마… 사실 그 사람은 그냥 덩치 큰 테디베어 같은 사람이야,” 그녀가 장난스럽게 말했다.
그 말을 듣고 둘 다 킥킥 웃었지만, 마크는 그다지 자연스럽지 않게 웃었다.
건배,
론 박사
패티가 가우시안 정규 분포 함수를 보완 오차 함수에 통합한 내용은 다음과 같습니다. P값을 계산하는Excel® 스프레드시트 사본을 원하시는 독자분들은 [email protected]으로 이메일을 보내주시기 바랍니다.