
여러분,
귀사가 솔더 페이스트 품질을 판단하는 핵심 지표로 전이 효율(TE)을 선정했다고 가정해 봅시다. 전사 효율은 스텐실에 도포된 솔더 페이스트의 부피를 스텐실 개구부의 부피로 나눈 비율입니다. 귀하도 TE가 중요한 지표라는 점에는 동의하지만, 최근 솔더 페이스트 평가 결과로 인해 다소 고민이 있습니다. 10가지 페이스트 중 2가지가 1위를 다투고 있으며, TE가 결정적인 평가 지표가 될 것으로 보입니다. 페이스트 A의 TE는 99.5%, 페이스트 B의 TE는 99%였습니다. 따라서 경영진은 페이스트 A를 채택하고자 합니다. 하지만 페이스트 A는 일시 정지 시 반응성이 좋지 않아 고민입니다. 스텐실에 15분 이상 방치하면 첫 번째 인쇄물을 폐기해야 하기 때문입니다. 이 약점으로 인해 3교대 근무 시 약 30분 정도의 생산 시간 손실이 발생할 수 있습니다.
그러나 TE 테스트 결과에 따르면, 페이스트 A의 TE가 페이스트 B보다 통계적으로 유의미하게 더 우수한 것으로 나타났습니다. 이 상황을 생각해 보면 뭔가 말이 안 되는 것 같습니다…….. 99.5%와 99%는 꽤 가까운 수치인데 말이죠.
통계학 교과서를 꺼내 먼지를 털어내고 가설 검정을 복습한다. 그러다 문득 깨닫게 된다. 표본 크기가 매우 클 경우, 서로 점점 더 가까워지는 평균값들 사이에도 통계적으로 유의미한 차이가 있을 수 있다는 사실을.
데이터에 따르면, 페이스트 A의 평균은 99.5%이고 표준편차는 10%인 반면, 페이스트 B의 평균은 99%이며 표준편차 역시 10%이다. 표본 크기는 각각 10,000개였다. 이처럼 큰 표본 크기는 분석에 있어 중요한 요소이다. 가설 검정에서 평균을 비교할 때는 평균의 표준오차(SEM)가 사용됩니다. SEM은 표준편차(s)를 표본 크기(n)의 제곱근으로 나눈 값으로 정의됩니다:
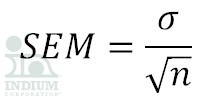
따라서 표본 크기가 커질수록 SEM은 더 작아지거나, 통계 용어로 말하면 “더 좁아진다.” 표본 크기가 매우 클 경우, 이러한 좁아짐 덕분에 서로 점점 더 가까워지는 평균값들을 통계적으로 구별할 수 있게 된다. 표본 크기가 100 미만일 때는 이러한 상황이 문제가 되지 않았으나, 오늘날의 최신 솔더 페이스트 부피 스캐닝 시스템을 사용하면 표본 크기가 1,000을 넘는 경우가 흔하다.
그림 1은 신뢰하한(TE)이 99.5%와 99.0%이고 표본 크기가 100인 표본에 대한 평균의 예상 표본 분포를 보여줍니다. 두 표본의 표준편차는 모두 10%입니다. 육안으로는 큰 차이가 보이지 않는다는 점에 유의하십시오. 그러나 평균과 표준편차가 동일하고 표본 크기가 10,000인 경우, 그림 2에서 볼 수 있듯이 평균의 표본 분포는 분명히 다릅니다.
하지만 실제로는 그림 1과 2의 결과에 아무런 차이가 없습니다. 평균값의 미세한 차이(0.5%)는 표본 크기가 10,000일 때 통계적으로 유의미할 수는 있겠지만, 실질적으로도 유의미할까요? 이 작은 차이가 실제 운영 환경에서 정말 중요한 문제일까요? 거의 확실히 그렇지 않을 것입니다.
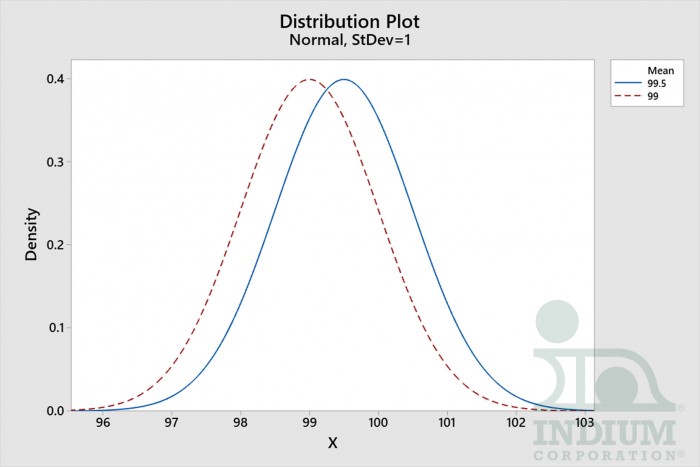
그림 1. 표본 크기가 100일 때의 평균의 표본 분포.
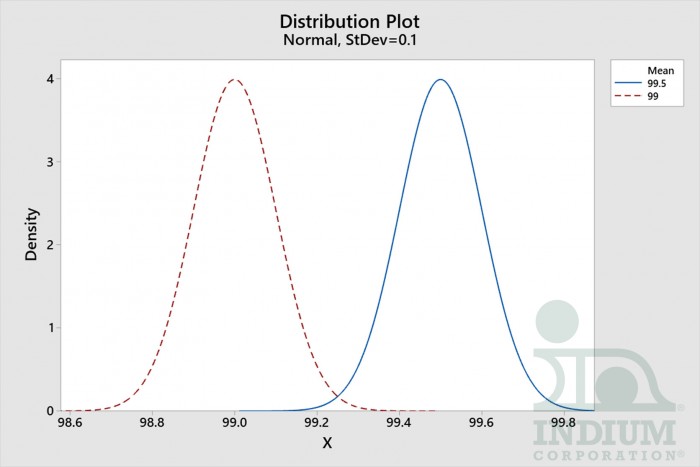
그림 2. 표본 크기가 10,000일 때의 평균의 표본 분포.
따라서 표본 크기가 클 경우, 그 차이가 실질적인 의미를 가지는지 스스로에게 물어봐야 합니다. TE의 경우, 0.5%의 차이는 실질적으로 유의미하지 않다고 확신할 수 있다고 생각합니다. 하지만 만약 그 차이가 2%나 5%라면 어떨까요? 어떤 수준의 차이가 유의미한지 판단하기 위해서는 분명히 실험을 수행해야 합니다.
앞서 논의한 사례를 고려할 때, 저는 TE가 99.0%이고 일시 정지 시 반응성이 좋은 페이스트를 훨씬 더 선호합니다.
건배,
론 박사


