
여러분,
C 차트 는 통제도 로, 속성 데이터를 추적하는 데 사용되는통제도입니다. 예를 들어, SMT 조립 공정 마지막 단계에서 불량 수를 추적하고 있다고 가정해 봅시다. 경영진은 10,000개당 조립품에 불량이 몇 개나 발생하는지 알고 싶어 한다고 밝혔습니다. 따라서 제조된 조립품 10,000개마다 불량 수를 추적합니다. 주임 공정 엔지니어로서 지난 6개월 동안 이러한 속성 데이터를 수집해 왔다고 가정해 봅시다. 분석을 단순화하기 위해, 매일 이만큼의 조립품이 생산된다고 가정합시다. 해당 데이터의 C 차트는 그림 1에 나와 있습니다. 슈하트 규칙 1 위반은 거의 확실하게 공통 원인 변동에 기인한 것임이 거의 확실합니다.
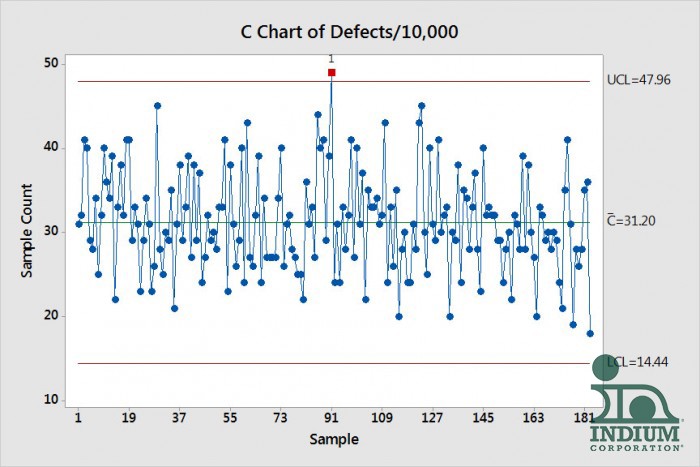
그림 1. 데이터 세트당 10,000개의 데이터에 대한 C 차트 데이터.
당신은 2주간의 휴가를 떠나고, 과로에 시달리던 동료 몇 명이 생산 라인을 모니터링하고 속성 데이터를 수집하기로 동의합니다. 안타깝게도, 당신이 자리를 비운 탓에 조립 라인에서 몇 가지 공정 문제가 발생했습니다. 그 결과, 매일 5,000개의 조립품만 생산되고 있습니다. 경영진은 새로운 데이터를 기존 데이터와 비교하고자 하지만, 표본 크기가 다릅니다. 5,000개당 결함 수에 표본 크기 비율을 곱하는 것이 합리적이며, 이 경우 비율은 2(10,000/5,000)입니다. 이렇게 수정된 새로운 데이터를 기존 데이터에 더하여 업데이트된 C 차트를 작성할 수 있습니다. 이 사례에서, 첫 3일간의 불량 데이터는 조립품 5,000개당 31개, 23개, 21개였습니다. 이 수치에 2를 곱하면, 데이터는 각각 62개, 46개, 42개가 됩니다. 2주 분량의 데이터에 대해 이 간단한 연산을 수행하고 기존 C 차트에 합산하면, 그림 2와 같은 새로운 C 차트가 완성됩니다.
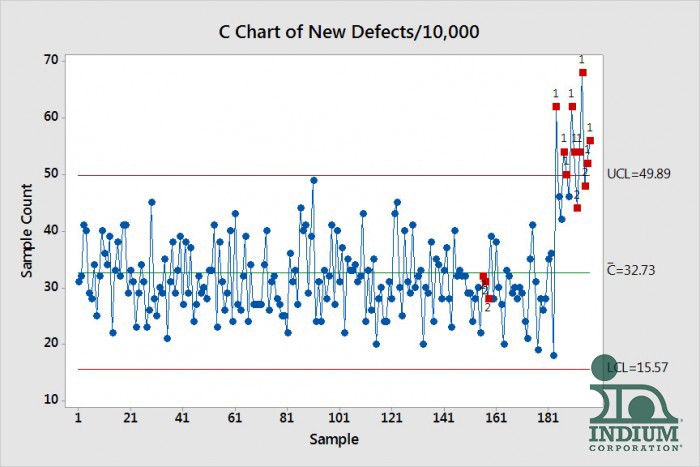
그림 2. 새로운 데이터 세트의 각 불량 수에 2를 곱함으로써 , 새로운 데이터를 기존 데이터에 더하고 새로운 C 차트를 생성할 수 있습니다. 셰하트 제1규칙 위반 사례가 다수 나타나는 것으로 보아, 새로운 데이터의 불량률이 더 높다는 점에 유의하십시오.
새로운 데이터를 보면, 수많은 셰하트 제1법칙 위반 사례에서 알 수 있듯이 불량률이 분명히 높아진 것을 확인할 수 있습니다. 이러한 결과는 조립 공정을 지원하기 위해 귀하께서 기울이고 계실 훌륭한 노력을 강력히 뒷받침합니다. 귀하가 자리를 비운 동안 생산량은 50% 감소했을 뿐만 아니라 불량률도 크게 증가했습니다.
이러한 데이터 변환을 수행할 수 있는 엑셀 스프레드시트를 만들었습니다. 관심이 있으시면 이메일을 보내 주시면 해당 스프레드시트를 보내드리겠습니다.
건배,
론 박사


