여러분,
지난 가을 선거를 지켜보면서 특정 여론조사가 다음과 같은 결과가 나왔다는 소식을 자주 들었습니다. 통계적으로 유의미한. 예를 들어, 1,000명을 대상으로 한 여론조사에서 A 후보가 51 대 49%로 B 후보를 앞섰지만 그 결과는 통계적으로 유의미하지 않았습니다. 오차 범위(MOE) 는 3%를 조금 넘었습니다. 이와 같은 예는 통계적 유의성이 중요하다는 느낌을 주는 것은 당연합니다. 그러나 표본 크기가 매우 큰 경우 이러한 유의성은 오해의 소지가 있을 수 있습니다. 이전에 이 주제에 대해 블로그에 올린 적이 있지만, 특히 정량적 예시를 통해 반복해서 설명할 필요가 있습니다.
이 예시를 위해 SMT 업계의 몇 가지 데이터를 살펴보겠습니다. 엔지니어가 3가지 솔더 페이스트의 성능을 평가하고자 한다고 가정해 보겠습니다. 전송 효율성 (TE). 목표 값은 100%입니다. 붙여넣기 1의 TE는 98%, 붙여넣기 2의 TE는 97%, 붙여넣기 3의 TE는 86%입니다. 모든 페이스트에 대한 데이터의 표준 편차는 20%입니다. 안타깝게도 그녀의 회사는 아직 현대식 SPI(솔더 페이스트 검사) 타입의 부피 측정 장치로 모든 솔더 페이스트 침전물을 현미경으로 측정해야 합니다. 따라서 그녀는 각 페이스트에 대해 20개의 샘플만 측정합니다. 위의 데이터와 각각 20개의 샘플을 가지고 통계 계산을 수행하여 95% 신뢰도로 페이스트 1과 2의 TE에 통계적으로 유의미한 차이가 없지만 두 페이스트가 모두 페이스트 3보다 우수하다는 것을 보여줄 수 있습니다.
하지만 한 달 후 회사에서 SPI 툴을 구입합니다. 이 도구는 솔더 페이스트 침전물을 매우 빠르게 스캔할 수 있어서 그녀는 3개의 페이스트 각각에 대해 20,000개의 침전물을 스캔합니다. SPI가 정확히 동일한 결과, 즉 페이스트 1의 TE가 98%, 페이스트 2의 TE가 97%, 페이스트 3의 TE가 86%로 나온다는 점은 위안이 됩니다. 모든 페이스트는 여전히 20%의 표준 편차를 보입니다.
그럼 결과는 같겠죠? 아니요. 물론 페이스트 1과 페이스트 2가 여전히 페이스트 3을 이겼지만, 이 경우에는 페이스트 1이 페이스트 2보다 통계적으로 우월합니다. 실제로 붙여넣기 2의 TE가 97.67%라고 하더라도 붙여넣기 1이 95% 신뢰도로 붙여넣기 2보다 통계적으로 우월합니다.
이러한 변화의 원인은 무엇인가요? 표본 크기와 관련이 있습니다. 평균의 95% 신뢰 구간 (CIM)은 부분적으로 표준 편차를 표본 크기의 제곱근으로 나눈 값에 의해 결정됩니다. 이 용어는 평균의 표준 오차 (SEM).
샘플 크기가 커질수록 SEM은 작아집니다. 그림 1은 평균의 샘플링 분포 은 표본 크기가 20인 경우 붙여넣기 1과 2에 대해, 그림 2는 표본 크기가 20,000인 경우를 보여줍니다. 각 분포의 평균에 대한 신뢰 구간은 화살표가 있는 선으로 표시되어 있습니다. 그림 1에서 표본 크기가 20인 경우 CIM이 강하게 중첩되어 통계적 차이가 없음을 알 수 있습니다. 반면, 그림 2에서는 CIM이 크게 분리되어 있어 이 두 분포가 통계적으로 크게 다르다는 것을 알 수 있습니다.
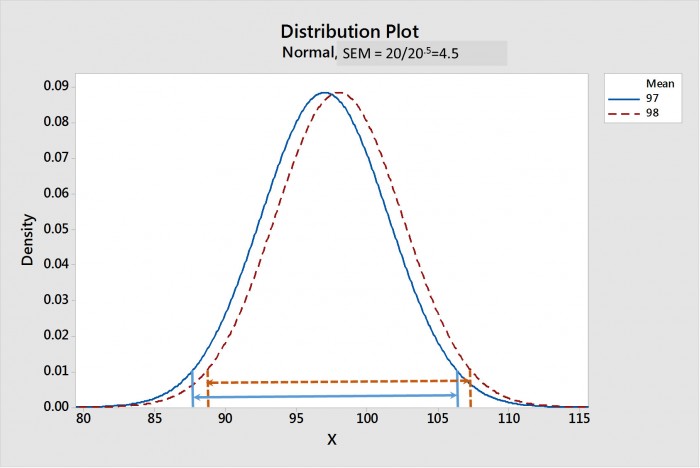
그림 1. 표본 크기가 20인 과거 1과 2에 대한 평균의 샘플링 분포입니다. 평균의 95% 신뢰 구간(CIM)은 화살표 선으로 표시되어 있습니다. CIM이 겹치므로 통계적 차이가 있음을 알 수 있습니다.

그림 2. 표본 크기가 20,000인 과거 1과 2에 대한 평균의 샘플링 분포입니다. 평균의 95% 신뢰 구간(CIM)은 화살표 선으로 표시되어 있습니다. CIM이 겹치지 않으므로 통계적으로 유의미한 차이가 있음을 알 수 있습니다.
이 상황은 우리에게 어떤 결과를 가져올까요?
표본 크기가 20,000개일 때 평균 TE가 98%인 경우와 97.67%인 경우 사이에 통계적으로 유의미한 차이가 있다고 말할 수 있다면 그 값에 의문을 제기해야 합니다. 예를 들어 경영진이 솔더 페이스트 구매 시 TE가 가장 중요한 변수라고 결정했다고 가정해 보겠습니다. 또한 페이스트 1의 TE가 98%이고 페이스트 2의 TE가 통계적으로 다른 97.67%라고 가정해 봅시다. 하지만 페이스트 1은 일시 정지에 대한 반응이 매우 낮습니다. 또한 다른 모든 성능 지표가 동일하다고 가정해 봅시다. 이 경우 붙여넣기 1과 2의 TE는 "실질적으로 크게" 다르지 않으므로 동일하게 간주해야 한다고 주장하고 싶습니다. 붙여넣기 2의 일시 정지 성능에 더 우수한 응답을 더하면 붙여넣기 2가 승자가 됩니다.
"실질적 중요성"은 어떻게 결정되나요? 사례마다 다르겠지만, TE의 경우 2~5% 범위의 차이는 실질적으로 유의미하지 않다고 주장하고 싶습니다. 대부분의 경우 엔지니어링은 몇 가지 실험을 통해 '실질적인 중요성'을 결정해야 합니다. 하지만 수천 개의 데이터 포인트를 측정할 수 있는 SPI 장치와 같은 최신 도구를 사용하면 통계적 차이와 실제적 차이의 이분법을 이해할 필요성이 점점 더 커지고 있음을 알 수 있습니다.
최근 샘플 크기가 20,000개가 넘는 일부 TE 데이터를 분석하면서 이러한 상황이 더욱 실감났습니다.
건배,
론 박사