아이비 대학교의 패티 콜먼 교수는 사이먼 피어스 레스토랑에서 혼자 점심을 먹으며, 레스토랑에 있는 아름다운 폭포를 바라보며 여유를 즐기고 있었다. 그녀가 이 레스토랑의 대표 메뉴인 체다 치즈 수프를 맛보고 있을 때, 눈썰미로 매기 벤슨을 발견했다.
“매기, 이리 와서 나랑 같이 놀자!” 그녀가 소리쳤다.
“와, 패티 교수님! 정말 오랜만이에요,” 매기가 감탄하며 말했다.
매기는 벤슨 일렉트로닉스의 대표이사이자 CEO였다. 패티는 약 10년 전 매기가 아이비 대학교를 졸업한 이후로 줄곧 그녀의 멘토 역할을 해왔다.
서로 인사를 나눈 뒤, 매기가 물었다. “저렴한 통계 소프트웨어가 있는지 아세요? 주요 통계 소프트웨어들의 가격이 천정부지로 치솟았는데, 우리는 그 많은 기능 중 몇 가지만 사용하고 있거든요.”
“어떤 기능을 사용하시나요?” 패티가 물었다.
“주로 단일 변수 및 두 변수에 대한 가설 검정이에요. 그리고 표본 수가 6개 이하인 경우의 일원 분산 분석도요,” 매기가 대답했다.
패티는 잠시 생각하더니 이렇게 말했습니다. “엑셀®을 아주 잘 다루는 제자가 한 명 있는데, 지금 프로젝트를 맡을 일이 필요해요. 그 학생과 상의해 보고, 선생님이 원하시는 기능을 수행할 수 있는 엑셀® 스프레드시트를 만들 수 있는지 알아보겠습니다.”
그날 늦게, 패티의 제자인 웬 차오가 매기의 팀에 연락을 취해, 팀이 현재 겪고 있는 통계 분석 문제에 대해 논의했다. 엔지니어들 중 상당수는 신입이라 통계 분석에 익숙하지 않았다.
팀의 리더인 메리 체임버스는 현재 직면한 어려움을 털어놓았다.
“현재 하단 단자형 부품 아래에서 발생하는 공극 발생률은 16.2%입니다. 브레인스토밍 회의에서 우리는 보이드 발생률을 5% 낮출 수 있는 솔더 페이스트를 찾을 수 있다면 그 제품으로 전환하기로 결론지었습니다. 새로운 페이스트를 테스트한 결과 보이드 발생률이 9.87%로 나타났기 때문에 전환을 권고하려 했습니다. 하지만 팀원 중 한 명인 던 레이놀즈가 ‘9.87%라는 수치가 통계적으로 유의미한지’를 물었고, 아무도 그 답을 알지 못했습니다.” 메리가 요약했다.
웬은 이렇게 대답했다. “던의 말이 맞습니다. 6% 이상 차이가 나기 때문에(즉, 16.2% – 9.87% > 6%), 목표를 달성했다고 말하고 싶은 유혹이 들겠지만, 결과가 통계적으로 유의미하다고 확신할 수는 없습니다. 데이터를 제게 보내 주시면, 결과가 통계적으로 유의미한지 판단할 수 있도록 계산을 수행하는 엑셀® 스프레드시트를 만들어 드리겠습니다. 오늘 데이터를 보내 주시면 며칠 내로 답변을 드릴 수 있을 것입니다.”
얼마 지나지 않아 웬은 이틀 뒤에 회의를 갖자고 요청하는 이메일을 보냈다.
메리와 던, 그리고 팀원 모두가 웬의 조사 결과를 기다리는 동안 시간은 마치 멈춘 듯 느리게 흘러가는 듯했다.
이틀 뒤, 웬이 도착하자 던이 그를 맞이했다. “你好 (Nǐ hǎo.)” 웬은 잠시 멍해졌다. 미국에서의 회의에서 중국어 인사를 듣는 데 더 이상 익숙하지 않았기 때문이다. 하지만 그는 웃음을 터뜨리며 금세 평정심을 되찾았다. 그와 던은 중국어로 몇 마디 더 나눈 뒤, 영어로 전환하기로 했다.
“와! 중국어를 정말 완벽하게 하시네요. 어디서 배우셨어요?” 웬이 물었다.
“제가 4살 때 아버지가 베이징에서 3년 동안 근무하게 되셨어요. 부모님은 저를 중국어 학교에 보내셨죠,”라고 던이 대답했다.
잠시 더 가벼운 대화를 나눈 뒤, 그들은 본론으로 들어갔다.
“가설 검정은 특정 지표가 요구 사항을 충족하는지 판단하는 데 유용한 방법입니다,”라고 웬이 말을 시작했다.
“여러분의 문제를 살펴보겠습니다. 평균이 11보다 작기를 원했는데, 결과는 9.867이었습니다. 이 결과는 11보다 작지만, 통계적으로 신뢰할 수 있을 만큼 작은 것일까요? 그림 1을 살펴보십시오. 이 그림은 평균이 11인 평균의 표본 분포를 나타낸 그래프입니다. 데이터가 정규 분포를 따른다고 가정해 봅시다. 분포의 폭은 평균의 표준오차입니다.”
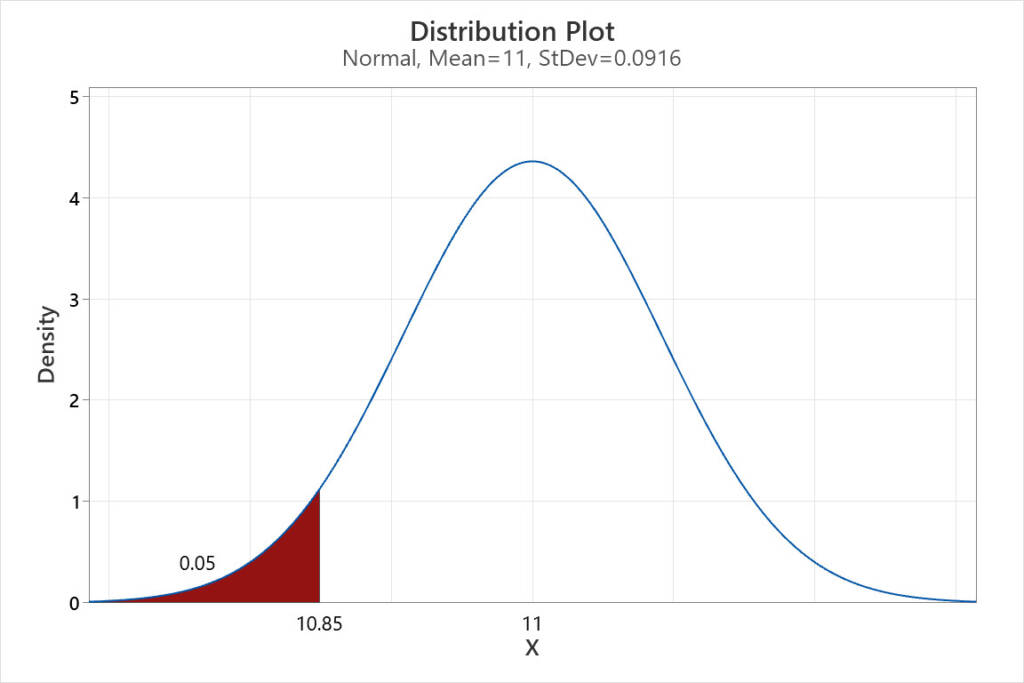
그림 1. 평균이 11인 평균의 표본 분포를 나타낸 그래프.
웬은 말을 이어갔다. “x축의 왼쪽 10.85 지점에서 곡선 아래의 면적이 음영 처리되어 있다는 점에 유의하십시오. 이 음영 처리된 면적은 곡선 아래 전체 면적의 5%에 불과합니다. 이를 해석하면, 실제 평균이 10.85보다 작을 확률은 5%라는 뜻입니다. 데이터에서 산출된 값이 9.87이므로, 실제 평균이 11보다 작다는 사실을 거의 확실하게 말할 수 있습니다.”
“이 분석은 매우 유용하지만, 이를 뒷받침하는 구체적인 계산은 무엇입니까?” 브래드 풀라거가 물었다.
“제 발표의 다음 부분으로 넘어가게 해 주셔서 감사합니다!” 웬이 웃음을 터뜨렸다. “계산을 수행하기 위해 엑셀® 스프레드시트를 만들었습니다.” 그림 2를 참조하십시오.
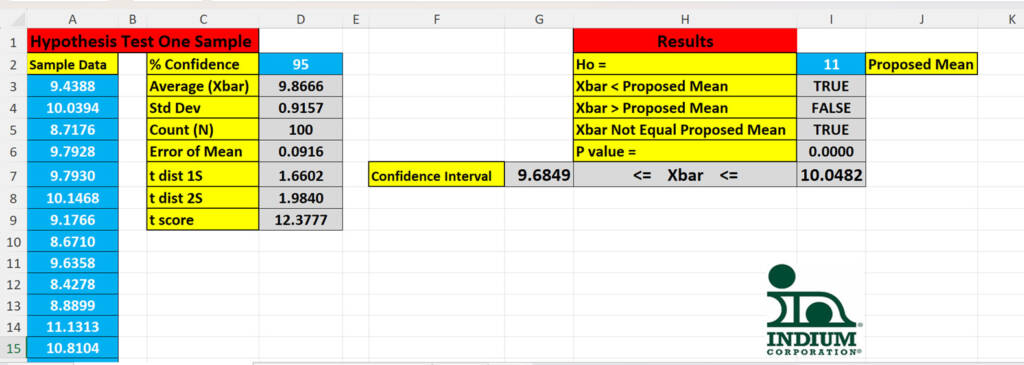
그림 2. 배뇨 데이터 분석을 뒷받침하는 Excel® 계산 결과 .
“사용자는 왼쪽 열인 A3:A102 셀에 데이터를 입력합니다. 또한 D3 셀에 원하는 신뢰 수준(이 경우 95%)을, I2 셀에 제안된 평균값 11을 지정합니다. 데이터 입력 셀은 파란색 바탕에 흰색 숫자로 표시된다는 점에 유의하십시오.”
“결과적으로 데이터의 평균(xbar)은 I3 셀에 제시된 평균보다 작습니다. p값(I6 셀)은 평균이 11보다 작다고 주장했을 때 그 주장이 틀릴 확률을 나타냅니다. 이 경우, 평균이 11보다 작지 않을 확률은 사실상 0%입니다. 회색 바탕에 검은색 글자가 표시된 셀은 계산 결과입니다.
“질문 있으신 분 계신가요?” 웬이 말을 마쳤습니다.
잠시 침묵이 흘렀고, 이어 팀원 6명이 일제히 박수를 터뜨렸다. 웬은 얼굴이 빨개지며 말을 잇지 못했다.
맷은 이렇게 요약했다. “대부분의 통계 소프트웨어는 사용하기가 정말 어렵게 느껴지는데, 당신이 만든 건 정말 간단하네요.”
에필로그: 그 주 후반, 한 친구가 사이먼 피어스에서 저녁 식사를 하고 있는, 웬과 던을 의심할 정도로 닮은 한 커플을 발견했다.
건배,
론 박사